Mostrando entradas con la etiqueta Programador. Mostrar todas las entradas

lunes, 3 de diciembre de 2018

Excepciones en Java 2/2

Continuando con el tema de Excepciones que empezamos en el artículo Excepciones en Java 1/2 hablaremos de los bloques try, catch, finally y la declaración try-with-resources la cual es particularmente adecuada para situaciones que usan recursos de Closeable.

Bloque try: El primer paso para construir un controlador de excepciones es encerrar el código que podría generar una excepción dentro de un bloque try.

try {
        código
}bloques catch y finally . . .

El segmento código contiene una o más líneas legales de código que podrían generar una excepción.

Si ocurre una excepción dentro del bloque try, esa excepción es manejada por un controlador de excepciones asociado con él. Para asociar un controlador de excepciones con un bloque try, debe poner un bloque catch después de él.

Bloque catch: Usted asocia los controladores de excepciones con un bloque try al proporcionar uno o más bloques catch directamente después del bloque try. Ningún código puede estar entre el final del bloque try y el comienzo del primer bloque catch.

try {

} catch (ExceptionType name) {

} catch (ExceptionType name) {

}

Cada bloque catch es un controlador de excepciones que maneja el tipo de excepción indicado por su argumento. El tipo de argumento, ExceptionType, declara el tipo de excepción que el manejador puede manejar y debe ser el nombre de una clase que hereda de la clase Throwable. El manejador puede referirse a la excepción utilizando name.

El bloque catch contiene código que se ejecuta cuando se invoca el controlador de excepciones. Los manejadores de excepciones pueden hacer más que solo imprimir mensajes de error o detener el programa. Pueden realizar la recuperación de errores, pedir al usuario que tome una decisión o propagar el error hasta un controlador de nivel superior utilizando excepciones encadenadas.

En Java SE 7 y versiones posteriores, un solo bloque catch puede manejar más de un tipo de excepción. En la cláusula catch, especifique los tipos de excepciones que el bloque puede manejar y separe cada tipo de excepción con una barra vertical (|):

catch (IOException | SQLException ex) {
    logger.log(ex);
    throw ex;
}

Nota: Si un bloque catch maneja más de un tipo de excepción, entonces el parámetro catch es implícitamente final. En este ejemplo, el parámetro catch ex es final y, por lo tanto, no puede asignarle ningún valor dentro del bloque catch.

Bloque finally: El bloque finally siempre se ejecuta cuando el bloque try sale. Esto asegura que el bloque finally se ejecute incluso si ocurre una excepción inesperada. Pero, finalmente, es útil para algo más que el manejo de excepciones: permite al programador evitar que un código de limpieza se omita accidentalmente con una devolución, una continuación o una interrupción. Poner el código de limpieza en un bloque finally es siempre una buena práctica, incluso cuando no se prevén excepciones.

Declaración try-with-resources: La declaración try-with-resources es una declaración try que declara uno o más recursos. Un recurso es un objeto que debe cerrarse después de que el programa haya terminado con él. La declaración try-with-resources asegura que cada recurso se cierre al final de la declaración. Cualquier objeto que implemente java.lang.AutoCloseable, que incluye todos los objetos que implementan java.io.Closeable, puede usarse como un recurso.

static String readFirstLineFromFile(String path) throws IOException {
    try (BufferedReader br = new BufferedReader(new FileReader(path))) {
        return br.readLine();
    }
}

Veamos como se vería los bloques try-catch-finally juntos:

try {
     // Código que puede lanzar una excepción
}catch(TipoExcepcion e){
    // Código para manejar la excepción
}finally {
   // Código que se ejecuta al final se lance o no una excepción
}

En mi repositorio de GitHub de Programación Orientada a Objetos puedes encontrar ejemplos concretos en la sección de excepciones.

Excepciones en Java 1/2

El artículo a continuación es una traducción y resumen del tutorial facilitado por Oracle, con algunos aportes personales.

Partamos por la definición.
Una excepción es un evento, que ocurre durante la ejecución de un programa, que interrumpe el flujo normal de las instrucciones del programa. 
Ahora bien, ¿Qué pasa cuando ocurre durante la ejecución uno de estos eventos?, realmente lo que ocurre es que el método donde se origina la excepción crea un objeto y lo entrega al sistema de tiempo de ejecución. El objeto, llamado objeto de excepción, contiene información sobre el error, incluido su tipo y el estado del programa cuando ocurrió el error. Crear un objeto de excepción y entregarlo al sistema de tiempo de ejecución se llama lanzar una excepción.

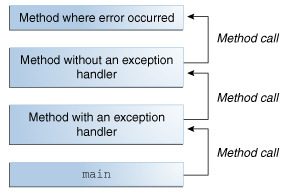
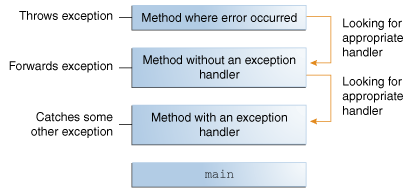
Después de que un método lanza una excepción, el sistema de tiempo de ejecución intenta encontrar algo para manejarlo. El conjunto de posibles "cosas" para manejar la excepción es la lista ordenada de métodos que se habían llamado para llegar al método donde ocurrió el error. La lista de métodos se conoce como la pila de llamadas.


El sistema en tiempo de ejecución busca en la pila de llamadas un método que contenga un bloque de código que pueda manejar la excepción. Este bloque de código se llama un controlador de excepciones (exception handler). La búsqueda comienza con el método en el que se produjo el error y continúa a través de la pila de llamadas en el orden inverso en que se llamaron los métodos. Cuando se encuentra un controlador adecuado, el sistema de ejecución pasa la excepción al controlador. Un controlador de excepciones se considera apropiado si el tipo del objeto de excepción lanzado coincide con el tipo que puede manejar el controlador. Se dice que el controlador de excepciones elegido captura la excepción. Si el sistema en tiempo de ejecución busca exhaustivamente todos los métodos en la pila de llamadas sin encontrar un controlador de excepción apropiado, como se muestra en la siguiente figura, el sistema en tiempo de ejecución (y, en consecuencia, el programa) termina.


El requisito de captura o especificación

Java válido debe cumplir con el requisito de captura o especificación. Esto significa que el código que podría generar ciertas excepciones debe estar incluido por uno de los siguientes:

  • Una declaración try que atrapa la excepción. try debe proporcionar un controlador para la excepción (catch).
  • Un método que especifica que puede lanzar la excepción. El método debe proporcionar una cláusula throws  que enumera la excepción o excepciones que puede lanzar el método.
El código que no cumple con el requisito de captura o especificación no se compilará.

No todas las excepciones están sujetas al requisito de captura o especificación. Para entender por qué, debemos observar las tres categorías básicas de excepciones, de las cuales solo una está sujeta al Requisito.

  1. Excepción comprobada (checked exception) : Estas son condiciones excepcionales que una aplicación bien escrita debe anticipar y recuperar. Las excepciones comprobadas están sujetas al requisito de captura o especificación. Todas las excepciones son excepciones verificadas, excepto aquellas indicadas por Error, RuntimeException y sus subclases.
  2. Error :  Son condiciones excepcionales que son externas a la aplicación y de las cuales la aplicación generalmente no puede anticipar o recuperar. Los errores no están sujetos a los requisitos de captura o especificación. Los errores son aquellas excepciones indicadas por Error y sus subclases.
  3. Excepción de tiempo de ejecución (RuntimeException) :  Son condiciones excepcionales que son internas a la aplicación y de las cuales la aplicación generalmente no puede anticipar o recuperar. Estos suelen indicar errores de programación, como errores lógicos o uso incorrecto de una API. Las excepciones de tiempo de ejecución no están sujetas al requisito de captura o especificación. Las excepciones de tiempo de ejecución son aquellas indicadas por RuntimeException y sus subclases.
Debido a que este artículo se ha extendido un poco lo dejare hasta acá y seguiremos en Excepciones en Java 2/2 donde abordaremos los bloques necesarios para controlar una excepción.

domingo, 2 de diciembre de 2018

Refactorización

Refactorización es el proceso de cambiar un sistema de software de tal manera que no altera el comportamiento externo del código pero mejora su estructura interna. Es una forma disciplinada de limpiar el código que minimiza las posibilidades de introducir errores. (Si quieres saber más sobre código limpio te invito a leer este artículos)

Con la refactorización puede tomar un mal diseño, incluso un caos, y volver a trabajar en un código  bien diseñado. Cada paso es simple, incluso simplista. Sin embargo, el efecto acumulativo de estos  pequeños cambios puede mejorar radicalmente el diseño. 

El problema de la refactorización es que puede ser costoso y altamente peligroso, puesto que se debe cambiar código que funciona por código que no sabemos si puede funcionar. Como solución a este inconveniente se recomienda que el código tenga pruebas unitarias automatizadas.

En este post solo veremos algunos método de refactorización, si quieres conocer un catalogo más amplio y detallado puede ingresar a https://www.refactoring.com/catalog/

Los métodos son:

  1. Rename: Consiste en cambiar el nombre de variables, métodos o clases según sea el caso con el fin de tener un código limpio, de esta forma el código sea más legible, mantenible entre otras características.
  2. Extract Function: En ocasiones se tienen métodos que tienen muchas líneas, realiza más responsabilidades de las que debería hacer o simplemente no queda claro para que se quiere ese método. Para solucionar lo anterior se debe crear un método o métodos donde se realice la operación que se quiere extraer del método principal con el fin de separar las responsabilidades o entender mejor el método.
  3. Inline: Un caso especifico del método en linea se presenta cuando tenemos uno o mas métodos cuyos códigos son lo suficientemente auto-explicativos como para poder prescindir de ellos. Bastará con sustituir las llamadas al método por el cuerpo de dicho método; pero esto también ocurre con las variables, en ocasiones se tiene una variables que solo se usa para almacenar un valor y posteriormente retornarlo.
  4. Extract Class: Cuando una clase hace el trabajo de dos, resulta torpe. En su lugar, cree una nueva clase y coloque los campos y métodos responsables de la funcionalidad relevante en ella.
  5. Encapsulated Fields: Consiste en cambiar los modificadores de acceso que se requieran. Por ejemplo se cambian métodos públicos a privados porque solamente se acceden desde la misma clase.

El camino es largo y conlleva aprender más métodos y adquirir nuevas destrezas pero te aseguro que dando este primer paso veras cambios significativos en tu código.

Para poner en práctica estos métodos puedes ingresar a mi repositorio https://github.com/cedaniel200/Refactorizacion donde encontraras una series de ejercicios simples para afianzar los conceptos vistos.

Adicionalemente te recomiendo este excelente libro de Martin Fowler llamado Refactoring: Improving the Design of Existing Code 1era Edición o su 2da edición.

Espero que si realizas mis ejercicios propuestos, al finalizarlos, me dejes un comentario con la retroalimentación de los mismos.

Para finalizar te recomiendo este otro artículo donde hablo acerca de los principios SOLID una destreza que debes adquirir si sigues el camino para ser un excelente desarrollador de software.

miércoles, 14 de noviembre de 2018

Programación Orientada a Objetos (POO) desde un Enfoque Simple

Este paradigma es descubierto en el año 1966, por Ole Johan Dahl y Kristen Nygaard, dos años antes que la programación estructurada, pero es adoptado después de esta.

Dentro de la POO existen dos conceptos claves.
  • Clase: Modelo o plantilla a partir del cual podemos crear los objetos.
  • Objeto: Un objeto es una unidad de software de estado y comportamiento relacionados, también puede describirse como la instancia de una clase.
Profundicemos un poco en los objetos, estos a menudo se utilizan para modelar los objetos del mundo real, esto incluye conceptos, cosas tangibles e intangibles que se encuentran en la vida cotidiana. Los objetos del mundo real comparten dos características: 
  • Estado 
  • Comportamiento
Por ejemplo, los perros tienen estado (nombre, color, raza, hambre) y comportamiento (ladrar, buscar, menear la cola). Un objeto almacena su estado en campos, atributos o variables  y expone su comportamiento a través de métodos o funciones, los métodos operan el estado interno de un objeto, pero para que dicho objeto o una clase realice alguna acción se debe enviar un mensaje, pero no basta con esto, ya que, para que el objeto o la clase procese el mensaje que recibe, debe poseer un método de coincidencia. Ilustremos lo anterior con un ejemplo escrito en Java.

Automovil auto = new Automovil();
auto.encender();

Como podemos ver, creamos a partir de la clase Automovil un objeto llamado auto al cual le enviamos el mensaje auto.encender() ya que queremos que encienda, pero para que esto se de la clase Automovil debe tener un método que coincida con encender()

Teniendo claro y comprendiendo los conceptos de Clase y Objeto, podemos hablar del Diseño Orientado a Objetos (DOO), que como menciona Rober C Martin en su libro Arquitectura limpia, "podemos utilizar  tres palabras mágicas para explicar la naturaleza del DOO: encapsulación, herencia y polimorfismo. La implicación es que el DOO es la combinación adecuada de estas tres cosas"

Encapsulación: Describe la capacidad de un objeto para ocultar sus datos y métodos del resto del mundo. Ocultar el estado interno y exigir que toda la interacción se realice a través de los métodos de un objeto se conoce como encapsulación de datos. Vemos la encapsulación con las variables privadas y métodos publicos de una clase.

Herencia: Diferentes tipos de objetos a menudo tienen una cierta cantidad de características en común entre sí, sin embargo, cada uno también define características adicionales que los hacen diferentes. La programación orientada a objetos permite que las clases hereden el estado y el comportamiento de uso común de otras clases. De aquí que Rober C Martin en su libro Arquitectura limpia la defina como "La redeclaración de un grupo de variables y funciones dentro de un ámbito de inclusión".

Polimorfismo: Es la capacidad de diferentes objetos para responder de manera diferente al mismo mensaje. Ejemplo: Tenemos dos clase EstudiantePregrado y EstudiantePosgrado que Heredan de la clase Estudiante, el polimorfismo nos permitiría que una variable de tipo Estudiante no se limite a referirse a un objeto de la clase EstudiantePregrado, ya que, puede hacer referencia a cualquier objeto de las clases descendientes de Estudiante.

Para finalizar hablemos de la Abstracción una palabra muy utilizada cuando hablamos de POO pero que es?, bueno se podría decir que la abstracción consiste en captar las características esenciales de un objeto, así como su comportamiento.

En mi repositorio de GitHub https://github.com/cedaniel200/Programacion-Orientada-a-Objetos encontraras algunos talleres donde puedes practicar los temas vistos y más, en caso de no poder solucionarlos, no te preocupes cada taller tiene una posible solución.

lunes, 12 de diciembre de 2016

Clean Code Capítulo 4 Comentarios


No se debería tener la necesidad de escribir algún comentario a excepción de unos pocos casos, si se sigue y aplica lo visto en los artículos anteriores de Clean Code; me refiero a ponerle nombres con sentido a las entidades del software y a sus variables, a escribir funciones cortas que hagan una sola cosa y que la secuencia de llamados en la funciones vayan contando la historia, contando qué hace el software.

Como mencioné al comienzo del artículo, hay unas cuantas excepciones en las que el autor de Clean Code nos dice que nos podemos tomar el tiempo para escribir un comentario. ¿A que se refiere con tomarnos el tiempo?, se refiere a que cuando se escribe un comentario se debe hacer consciente de lo que queremos plasmar y hacerlo de  una forma que aporta información (comentario de calidad), ya que, muchas veces no nos tomamos el tiempo necesario y nuestros comentarios terminan convirtiéndose en desinformación que hace menos legible el código; un claro ejemplo es dejar código comentado, este código es obsoleto y los programadores que lo vean muy rara vez lo borran creyendo que hay algo importante en ellos, de esta forma perduran en el tiempo. Veamos cuáles son los casos en que debemos tomarnos el tiempo para escribir un comentario:

  • Comentarios Legales, cabe aclarar que en lo posible se debe hacer referencia a una licencia estándar o a un documento externo y no poner todos los términos y condiciones en el comentario.
  • Comentarios Informativos, solo cuando sea necesario, en los otros casos tratar de utilizar nombres con sentido.
  • Explicar la Intención, pueden ayudar a entender porque un programador tomó una determinada decisión al escribir una línea o bloque de código.
  • Clarificación, estos comentarios suelen utilizarse cuando se implementa alguna API estándar que no puede ser modificada.
  • Advertir las consecuencias, en ocasiones determinado código debe escribirse estrictamente de una manera o hacer uso de algún componente, en estos casos es útil advertir la consecuencia si se modifica o cambia el código.
  • Comentario TODO, estos comentarios hacen referencia a una tarea que el programador piensa que se debe hacer pero que no realizó, como por ejemplo, una implementación por hacer, un recordatorio para agregar o eliminar alguna función.
  • Amplificación, estos comentarios buscan ampliar la importancia de un determinado fragmento de código con el fin de que no pase como irrelevante.
  • Javadoc en API públicas, sólo cuando el API es pública se debe describir, pero se debe hacer con calidad, por esto quiero citar un consejo dado por el autor de Clean Code “los javadoc pueden ser tan ambiguos, amplios y descorteses como cualquier otro tipo de documento”.

Recuerden que antes de colocar un comentario nos debemos asegurar si no hay una mejor forma de escribir el código para evitar el comentario, por tanto quiero terminar con la frase con que comienza el capítulo de comentarios en el libro Clean Code.

 “No comente el código incorrecto, reescríbalo
Brian W. Kernighan y P.J. Plaugher

Nota: Para más artículos relacionados ver Clean Code.

lunes, 5 de diciembre de 2016

Principios SOLID


SOLID, es un acrónimo introducido por Robert C. Martin (autor de libro Clean Code y coautor del manifiesto Ágil), este acrónimo representa 5 principios claves en la programación Orientada a Objetos (POO). Veamos el acrónimo y a qué principios se refiere:

Single responsibility (Principio de Responsabilidad Única)
Open-Closed (Principio de Abierto/Cerrado)
Liskov substitution (Principio de Sustitución de Liskov)
Interface segregation (Principio de Segregación de la Interfaz)
Dependency inversion (Principio de Inversión de Dependencia)

Lo ideal es que conozcas y  utilices cada uno de estos principios a la hora de desarrollar software, debido a que nos ayudan a que nuestro diseño sea bueno, limpio y claro, obteniendo así aplicaciones fáciles de mantener y escalar, pues nos ayuda a lograr uno de los objetivos relevantes de la POO, el cual consiste en tener una alta cohesión (la clase debe enfocarse en hacer una sola cosa del sistema) y un bajo acoplamiento (la clase debe tener la menor cantidad de dependencias posibles).

Los principios SOLID en combinación con Clean Code te permitirán obtener aplicaciones fáciles de leer y comprender lo que ayuda a un más al momento de mantener, escalar y conseguir alta cohesión y un bajo acoplamiento; en pocas palabras, se complementan y se potencian mutuamente.

sábado, 3 de diciembre de 2016

Clean Code Capítulo 3 Funciones


Al crear software debemos proporcionar mecanismos para llevar a cabo diferentes acciones, por esto aparecen las Funciones. En Clean Code, se hace énfasis en lo importante que es crear cada función para hacer una cosa, que vayan contando una historia y que cada una lleve a la siguiente. Si observamos secciones en funciones (por ejemplo declaraciones, inicializaciones y filtros), es una clara señal que la función hace más de una cosa, otro caso es cuando una función hace lo que dice que hace en su nombre, pero hace algo extra (se está incumpliendo la regla de hacer una cosa) generando un efecto secundario inesperado, siempre recordemos que las funciones son sin efecto secundarios, por lo tanto, si es necesario, se debe pensar en refactorizar. Una función debe responder a algo o hacer algo, pero no las dos cosas, de ahí que surge lseparación de consultas de comando, el autor lo expresa de la siguiente manera "Su función debe cambiar el estado de un objeto o devolver información sobre el mismo, pero ambas operaciones causan confusión".

Al darles nombre no olvidemos el capítulo nombres con consentido, por esto se debe usar nombre descriptivos, que revelen la verdadera intención o acción de la función, una recomendación es utilizar verbos y palabras claves como por ejemplo writeField(name). write (Verbo), Field (Palabra Clave).

Cada función debe ser de tamaño reducido, ¿Cuántas líneas? no sabría decirte con exactitud, pero si nos basamos en el libro, este nos recomienda que tengan una longitud aproximada de 20 líneas, en estas líneas hay que prestar mucha atención a los bloques y sangrados. Cuando hablo de bloques hago referencia a fragmentos de códigos dentro de if, else, for y similares, en este caso la recomendación es que su longitud sea de una sola línea (lo más probable es que se invoque a otra función); en cuanto al nivel de sangrado no debe ser mayor a dos, ayudando a que haya un nivel de abstracción por función haciendo más fácil de comprenderla, con lo anterior se puede leer el código de arriba a abajo (la regla descendente). Esta regla consiste en posicionar las funciones por nivel de abstracción, como lo explican en Clean Code "Queremos que tras todas las funciones aparezcan las del siguiente nivel de abstracción para poder leer el programa, descendiendo un nivel de abstracción por vez mientras leemos la lista de funciones".

Otra parte clave en las funciones son sus argumentos, cuyo número ideal es cero, posteriormente uno (mónadico) y dos (diádico); se debe evitar las funciones de tres argumentos (triádico), las de más de tres argumentos (poliádico) deben tener una motivo especial. Las formas monádicas habituales son tanto para preguntar sobre el argumento o para transformar el argumento en otra cosa, un caso poco habitual es para eventos, en este caso las funciones por lo general no devuelven nada. En este punto el autor desaconseja utilizar argumentos de indicador (Pasar un booleano a una función) ya que de una forma u otra está indicando que la función hace más de una cosa. Para las funciones diádicas se debe propender que los argumentos sigan y tengan un orden natural, cuando estos carecen de dicho orden debe el programador utilizar los mecanismos necesarios para evitarlas. Cuando una función requiere dos o más argumentos se suele utilizar Objetos Como argumentos, pero esto no es una trampa, pues suele suceder que las variables antes pasadas como argumentos pertenezcan a un concepto más grande. Los nombres de los argumentos deben ser claros y acordes al contexto.

Algunas funciones tienen argumentos de salida, es decir, ver argumentos que en vez de ser entrada son salidas, estos argumentos deben evitarse.

El manejo de errores en una función en muchos casos se hace por medio de códigos de error, que suelen estar en una clase o varias lo que va creando alto acoplamiento y cuando surge un nuevo tipo de error, es donde viene los dolores de cabeza, por esto es mejor emplear excepciones que devolver código de error. Al utilizar excepciones es inevitable utilizar Try/Catch esto empieza a generar estructuras anidadas por eso es una buena práctica extraer bloques Try/Catch, esto quiere decir que se debe crear una función donde se procesa el error (dónde está la estructura Try/Catch, el procesamiento de errores es una cosa), desde esta se invocará la función que realizará la acción.

Antes de terminar quiero mencionar las instrucciones Switch, donde el autor hace una mención específica diciendo "Mi regla general para las instrucciones Switch es que se pueden tolerar si solo aparecen una vez, se usan para crear objetos polimórficos y se ocultan tras una relación de herencia para que el resto del sistema no las pueda ver. Evidentemente, cada caso es diferente y en ocasiones se puede incumplir una o varias partes de esta regla".

Las funciones nos ayudan a realizar acciones concretas, es nuestro deber evitar el no repetir código, por eso se deben crear con la mayor responsabilidad y dedicación y sin miedo a reescribir cuantas veces se crea necesario hasta que el resultado satisfaga las necesidades.

Nota: Para más artículos relacionados ver Clean Code.

lunes, 28 de noviembre de 2016

Clean Code Capítulo 2 Nombres con Sentido (2/2)


Continuando con la segunda parte del capítulo 2, vamos a seguir viendo aquellas reglas para crear nombres correctos. Si aún no has visto la primera parte te invito para que la veas.

Nombres de clases: Los nombre de clases no deben ser verbos. Los nombres deben proporcionar de manera clara el propósito de la clase, por lo general debe ser un sustantivo, evitando nombres genéricos. Algunos ejemplos de nombres correctos serían: Persona, Direccion, Cliente. Algunos nombres incorrectos de clases podrían ser: Info, Procesador, CalcularNomina.

Nombre de métodos: Debe ser un verbo como por ejemplo, eliminar, agregar, guardar. Los métodos de acceso, modificación deben tener como nombre su valor y usar como prefijo get, set e is. Como recomendación el autor dice, que “Al sobrecargar constructores use métodos de factoría estáticos con nombres que describan los argumentos

No se exceda con el atractivo: Esta regla hace referencia a no utilizar nombres provenientes de formas coloquiales de decir las cosas o de jergas, dejando a un lado la claridad, ya que, si llega un nuevo programador que no conozca estas formas de decir las cosas, se llenará de desinformación. 

Un nombre por concepto: Es simple, cuando nos decidimos por una palabra para representar un concepto, esta debe ser constante por todo el código y no utilizarse en unos lados y en otros no. Por ejemplo, no es conveniente utilizar en algunos nombres de métodos la palabra get y en otros retrieve. 

No haga juego de palabras: Se refiere a no utilizar una palabra con dos fines distintos, por ejemplo, digamos que en nuestro código hemos venido utilizando la palabra remove para nombrar métodos que inactivan, y en algún momento somos tentados a utilizar remove para hacer referencia a un método que elimina, en este caso sería mejor utilizar el nombre delete para el método en cuestión.

Usar nombres de dominio de soluciones: No es necesario que todos los nombres utilizados sean extraídos del dominio del problema, ya que, los lectores del código son programadores y ellos conocen o están familiarizados con términos informáticos, de patrones, y demás. Por ejemplo para un programador va a tener mucho sentido si una clase tiene el nombre de ListAdapter.

Usar nombre de dominios de problema: Cuando no se pueda cumplir la regla anterior porque no existe un término en el ámbito de programación, se debe recurrir a un nombre del dominio del problema. El autor nos dice “Separar los conceptos de dominio de soluciones y de problemas es parte del trabajo de un buen programador y diseñador”.

Añadir contexto con sentido: Cuando los nombres no tiene sentido por sí mismo, es necesario crearle un contexto que enriquezca dicho nombre, esto puede hacerse convirtiendo variables en parte de un concepto mayor, es decir, extraer una clase de la cual hagan parte o en una función o método que aporte un contexto. Como última instancia usar prefijos.

No añadir contextos innecesarios: Se refiere a no agregar en los nombres más información de la necesaria. Imagine una clase llamada DireccionResidencia y otra DireccionTrabajo, estos nombres no son realmente adecuados para una clase, lo mejor sería una clase Direccion y estos nombres serían ideales para nombre de instancias. Otro caso es agregar prefijo al nombre de las clases.


Como hemos visto en estos dos post acerca de nombres con sentido, el elegir un nombre adecuado para cada parte del código es fundamental, tanto para la legibilidad como para entender qué se hizo o qué se va a hacer. Para dar un nombre adecuado es necesario emplear habilidad descriptiva, gran vocabulario, conocimiento técnico y dejar los miedos, es momento de empezar a buscar mejores nombres, agregar o quitar el exceso de contexto, refactorizar el código, cambiando los nombres que no sean adecuados en el código existente.

Nota: Para más artículos relacionados ver Clean Code

viernes, 25 de noviembre de 2016

Clean Code Capítulo 2 Nombres con Sentido 1/2


A medida que escribimos código es inevitable enfrentarnos a la tarea que aunque parece trivial no lo es, de asignar nombre a una variable, clase, paquete, archivo etc. Cuando digo que no es trivial, quiero hacer énfasis a su importancia y a que al poner un nombre se debe hacer con responsabilidad y profesionalismo (lógica, coherencia y mucho sentido), puesto que estos nombres empezarán a dotar de sentido al código mismo, y de eso nos daremos cuenta al momento que otros programados lo lean o hasta nosotros mismos cuando con el tiempo debamos realizar mantenimiento sobre este. El autor de Clean Code sabe esto, por tal motivo nos proporciona una serie de reglas básicas para crear nombres correctos.

Usar nombre que revelen las intenciones: Cuántas veces hemos encontrado una variable con nombre así: int a; ¿Esto te dice algo?, ¿Sabes para qué sirve la variable a o que significado tiene?, precisamente de eso se trata esta regla, dotar de significado y sentido a través de su nombre, por ello el autor nos dice “El nombre de una variable, función o clase debe responder una serie de cuestiones básicas. Debe indicar por qué existe, qué hace, y cómo se usa”. Veamos un ejemplo tomado de Clean Code.

Incorrecto
public List<int[]> getThem(){
List<int[]> list1 = new ArrayList<int[]>();
for(int[] x : theList)
if(x[0] == 4)
  list1.add(x);
return list1;
}

Correcto
public List<int[]> getFlaggedCells(){
List<int[]> flaggedCells = new ArrayList<int[]>();
for(int[] cell : gameBoard)
if(cell[STATUS_VALUE] == FLAGGED)
  flaggedCells.add(cell);
return flaggedCells;
}

Evitar la desinformación: En ocasiones damos nombre ambiguos o que pueden más que informar, desinformar, ya que, da pistas erróneas de lo que en realidad hace una función, variable o clase. En otras oportunidades tenemos variables casi con el mismo nombre donde solo las diferencia una pocas letras o una pequeña palabra, es decir, nombre con variaciones mínimas. Estos casos nos dificultan la lectura del código, razón por la que debemos mejorar en dicho aspecto. Veamos unos ejemplos.

Incorrecto
Correcto
Explicación
tmp
temperatura
Algunos pensaran que tmp, hace referencia a temporal o tiempo
lugarXCoordenadas
lugarYCoordenadas
coordenadasOrigen
corrdenadasDestino
los nombres tienen forma similar
o
-
Nombrar una variable como o puede hacer que se confunda con el cero, al igual que no brinda ninguna información

Realizar distinciones con sentido: Esta regla va de la mano con la anterior cuando se habla de no tener nombre con variaciones mínimas, debido a que esta regla propone que a dichos nombres se le agregue aparte de una notable variación, sentido, como lo dice el autor “Si los nombres tienen que ser distintos, también deben tener un significado diferente”. Imaginemos que tenemos en una función que recibe dos variables num1, num2, lo primero que notamos es que en sus nombres no tienen una gran diferencia y segundo no da mucha información, ahora, si esta función lo que hace es dividir el primer parámetro (num1) con respecto al segundo (num2), tendría mas sentido llamarlos dividendo y divisor respectivamente.

Usar nombres que se puedan pronunciar: Cuántas veces haciendo mantenimiento al código tienes que dirigirte a un colega para alguna explicación o aclaración, cómo le dirías, o mejor, cómo pronunciarías la variable llamada genymdhms (fecha de generación, año, mes, día, hora, minuto y segundo), ¿no crees que es mejor generationTimestamp? - Ejemplo tomado del libro Clean Code -. Quizás tu colega no te entienda o tenga que ver con sus propios ojos de que le estás hablando, de ahí la importancia de colocar nombres que puedas pronunciar; la programación es una actividad social.

Usar Nombres que se puedan buscar: Aunque es una regla muy lógica, solemos pasar por alto y cuando debemos buscar una variable llamada t, en todo un proyecto o solo en una clase de muchas líneas obtendremos muchos falsos positivos, no sería más fácil buscar una variable llamada TEMPERATURA_MAXIMA_PERMIDA, siendo esta una constante.

Evitar codificaciones: Crear codificaciones para nombre supone una carga extra que debemos aprender y por lo general son difíciles de pronunciar lo que estaría rompiendo la regla de Usar nombres que se puedan pronunciar.

Notación húngara: El autor nos quiere decir que este tipo de notación o codificación en la actualidad no es necesaria y lo que genera son obstáculos que dificultan la lectura del código. Pero, ¿qué es la notación húngara?, es un sistema utilizado para crear los nombres de las variables, este sistema utiliza prefijos para indicar el tipo de dichas variables, por ejemplo, se utiliza el prefijo b para las variables booleanas (bIsCanceled).

Prefijo de miembros: Ya no es necesario utilizar esa práctica que aconsejaba agregar el prefijo m_ a los nombre de variables, los entornos actuales nos permite identificar los miembros ya sea que los resalta o les cambia el color.

Interfaces e implementaciones: Agregar adornos a los nombre de las interfaces (por ejemplo una I inicio del nombre), es agregar más información de lo necesario, y en caso de necesitar implementar dicha interfaz se puede agregar el sufijo Impl, por ejemplo, si tenemos la Interfaz Presenter (note que no la llame IPresenter) su implementación podría llamarse PresenterImpl.

Evitar asignaciones mentales: La asignación mental ocurre cuando el nombre de una variable debe ser traducido mentalmente por quien lee el código para relacionar con algún término del dominio, este problema es habitual con nombres de variables de una sola letra.


Nota: Como el post se está haciendo muy extenso y no quiero cansarte, he decidido tomar aquel consejo de "divide y vencerás". Por tal razón terminaré de contarles acerca del capítulo 2 de Clean Code en el siguiente post (Clean Code Capítulo 2 Nombres con Sentido (2/2)). Para más artículos relacionados ver Clean Code

martes, 22 de noviembre de 2016

Clean Code Capítulo 1 Código Limpio


El capítulo 1 trata brevemente distintos puntos partiendo del código incorrecto, que no es más que código sin sentido, y que lastimosamente es el que más abunda en nuestras aplicaciones. Estamos hablando de código que a simple vista no deja ninguna pista de que hace o para qué sirve y por esa razón perdemos tiempo buscando su significado o buscandole sentido. Lamentablemente, estoy de acuerdo con el autor cuando dice que “Todos hemos sentido alivio de ver cómo un programa incorrecto funcionaba y hemos decidido que un mal programa que funciona es mejor que nada” y hemos postergado su solución (Ley de LeBlanc: Después es igual a nunca). Con el pasar del tiempo vemos como los problemas se van agravando y se reflejan en el costo, principalmente de tiempo (El equipo es menos productivo), pero todos sabemos que el tiempo es oro, por ende, este tiempo que nos cuesta mantener el código incorrecto (ningún cambio es trivial) se convierte en dinero y puede significar hasta la muerte de un proyecto. Por lo anterior, quiero citar al autor cuando dice “ya sabrá que dedicar tiempo a que el código sea correcto no solo es rentable, es una cuestión de supervivencia profesional”. En pocas palabras, nos llenamos de código incorrecto, pero ¿Porque ocurre esto? la respuesta está en el libro cuando declara que la culpa es nuestra, ya que, “No somos Profesionales” y no debemos descargar nuestra responsabilidad en los demás pues “Tampoco sería profesional que los programadores cedieron a la voluntad de los jefes que no entienden los riesgos de un posible desastre”. 


Seguidamente, profundiza en lo que es código limpio o de su concepto, mostrando una serie de definiciones dadas por grandes programadores como Bjarne Stroustrup, inventor de C++. Interiorizando todas estas definiciones, he llegado a la siguiente definición de código limpio:


Código con sentido, concreto, dotado de características como la simplicidad, eficiencia, legibilidad, sencillez, debe estar testeado, tener dependencias mínimas y hacer una cosa bien (este último tomado de la definición de Bjarne Stroustrup)


Por último, habla brevemente de la regla del Boy Scout, que en pocas palabras es entregar el código más limpio de lo que lo hemos recibido.


Este capítulo nos invita a que abramos nuestros ojos para ver la posible falta de profesionalismo que nos invade al momento de crear código y empecemos el cambio para escribir código limpio, buscando así ser profesionales en esta área. ¡Ya diste el primer paso!, que suele ser el más difícil. Sigue caminando.

Nota: Para más artículos relacionados ver Clean Code

lunes, 21 de noviembre de 2016

Clean Code - Código Limpio


El desarrollo de software es algo que me apasiona, particularmente la programación, lo que me ha llevado últimamente a querer dar un paso más hacia la profesionalización en este ámbito. Por tal motivo he empezado a estudiar sobre patrones de arquitectura y de diseño en lo que respecta al software, e indagar sobre el concepto de Código Limpio (Clean Code); por lo anterior inicié leyendo el libro Clean Code de Robert C. Martín, y me he animado a escribir sobre lo que voy conociendo con la lectura del mismo, una serie de artículos acerca de mis impresiones sobre el libro.


Por ahora quiero citar una frase que he visto que relacionan con este libro y es que “Todo programador debe leerlo”, cuando leí por primera vez esta frase fui un poco escéptico, pero al ir devorando cada una de las páginas e ir interiorizando poco a poco sus conceptos me ha convencido, por eso inició invitandote a leer este libro, lleno de pequeños y simples detalles que hacen grandes cambios, apoyado en lo escrito por James O. Coplien en el prólogo “Que dichas acciones sean simples no significan que sean simplistas, y mucho menos que sean sencillas”.  


Manos a la obra, tienes mucho que leer, interiorizar, cambiar y ajustar. El camino es largo pero interesante y muy gratificante en cuanto empiezas a ver los resultados. Muy pronto, a medida que vaya leyendo más sobre este grandioso libro, estaré publicando al respecto y actualizando este post con los enlaces a los respectivos artículos.

Artículos Relacionados

Te dejo acá una referencia en donde puedes comprar la versión en español o lo puedes mirar acá en Amazon.

Instalación NodeJS

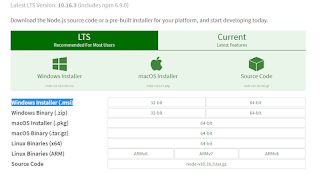
Ingresamos a la página oficial de NodeJS donde lo descargaremos  https://nodejs.org/en/download/ Escogemos el instalador que se ajuste a ...